Mostrando postagens com marcador computador. Mostrar todas as postagens

terça-feira, 30 de novembro de 2010

Ahmadinejad admite 

que centrífugas iranianas 

foram afetadas por vírus


O presidente iraniano, Mahmud Ahmadinejad, afirmou nesta segunda-feira que várias centrífugas que produzem urânio enriquecido foram desativadas por programas instalados no material eletrônico, em uma alusão ao vírus informático Stuxnet.

O problema foi solucionado, acrescentou Ahmadinejad, primeiro dirigente iraniano a reconhecer que o programa nuclear deste país foi vítima de um vírus.

"Eles conseguiram, de maneira limitada, desativar várias de nossas centrífugas, mas nossos especialistas puderam intervir e já não poderão voltar a fazê-lo", declarou o presidente respondendo a uma pergunta sobre os problemas sofridos pelo programa de enriquecimento do urânio iraniano.

Ahmadinejad não precisou sobre quem se referia ao usar o pronome 'eles'. Também não pronunciou exatamente a palavra vírus.

O Irã se viu afetado em junho passado pelo vírus Stuxnet.

Recentemente, um funcionário iraniano afirmou que 30.000 computadores industriais foram infectados pelo vírus.

"Este vírus foi criado há um ano e reuniu informações sobre os computadores industriais", acrescentou.

Depois disse que os computadores pessoais foram os mais afetados pelo vírus.

Minutos antes, Ahmadinejad afirmou nessa entrevista coletiva que o "Irã tem o direito de enriquecer urânio e produzir combustível (para suas instalações nucleares) e este direito não é negociável".

Ahmadinejad fez a declaração antes da reunião de 5 de dezembro do Irã e das potências do grupo "5+1" (Estados Unidos, Rússia, China, França, Grã-Bretanha e Alemanha) para tentar retomar o diálogo, interrompido há um ano, sobre o programa nuclear iraniano.


FONTE: UOL / AFP

Notícia divulgada em 29.11.2010

quinta-feira, 18 de novembro de 2010

China redirecionou tráfego da web para

 seus servidores, dizem EUA


A China redirecionou cerca de 15% do tráfego de toda a internet para servidores do país durante 18 minutos, abrangendo inclusive informações importantes do governo americano, afirma um relatório do governo dos Estados Unidos.

Segundo o estudo, divulgado nesta quarta-feira, o incidente ocorreu em abril deste ano, causado pela empresa de telecomunicações chinesa China Telecom.

O governo americano diz que ainda não é possível avaliar se o redirecionamento foi intencional e, se foi este o caso, qual seu objetivo.

"No entanto, pesquisadores de segurança da computação notaram que esta competência poderia permitir várias atividades mal-intencionadas", afirma o relatório, feito pela Comissão de Revisão Econômica e de Segurança das Relações EUA-China.

Entre o tráfico redirecionado para servidores chineses, estão trocas de e-mails entre funcionários do governo e acessos aos sites oficiais do Senado americano, do gabinete do Departamento de Defesa, da Nasa e do Departamento do Comércio.

Nesta semana, o secretário de Defesa americano, Robert Gates, pediu que as agências militares e civis dos Estados Unidos atuem mais fortemente e em conjunto contra as ameaças de ciberataques.

Estados inimigos

Já na Grã-Bretanha, especialistas ouvidos pela Comissão de Ciência e Tecnologia do Palamento afirmaram que um ciberataque capaz de ter efeitos profundos na infraestrutura do país somente poderia ser lançado por um Estado inimigo --o que faria uma ação do tipo "politicamente improvável".

O especialista Ross Anderson, da Universidade de Cambridge, disse aos parlamentares que o poder público deve ser mais atento para questões de tecnologia da informação, e lembrou um caso em que esteve diretamente ligado a um ciberataque.

"Alguns anos atrás, um aluno meu ajudou o gabinete do Dalai Lama a se livrar de um malware (programa que se infiltra em um computador ou em uma rede com o objetivo de causar danos ou roubar dados) claramente criado pelo governo chinês", disse.


FONTE: FOLHA.COM / BBC BRASIL

Notícia divulgada em 17.11.2010

sexta-feira, 12 de novembro de 2010

Tribunais precisam se preparar para processo eletrônico


O protótipo das funcionalidades do sistema de informática do Processo Judicial Eletrônico (PJE) para a área criminal foi apresentado na última quarta-feira (10/11) pelo Conselho Nacional de Justiça (CNJ) a representantes do Tribunal Regional Federal da 4ª Região. O sistema, desenvolvido pelo CNJ, será colocado à disposição dos tribunais, gratuitamente, mas os tribunais precisam se preparar para recebê-lo, alerta o conselheiro Walter Nunes da Silva Jr. O objetivo da reunião de quarta-feira, além da apresentação das novas ferramentas do PJE, foi a troca de experiências e conhecimentos. A versão atual do PJE está em funcionamento como projeto piloto na Justiça Federal da 5ª Região.


“O PJE é mais do que a troca de papel, é a automação do serviço jurisdicional”, ressalta Walter Nunes, prevendo a necessidade de equipamentos nos tribunais e também a reorganização do quadro de pessoal das secretarias das varas: “Vamos ter a reengenharia das estruturas de funções a serem desempenhadas”. É que várias tarefas feitas hoje manualmente por servidores deixarão de existir com a automação do serviço, e os servidores terão que ser requalificados para o novo tipo de função.


“Vamos precisar de mais juízes e menos servidores”, comenta Walter Nunes. Ele exemplifica: o processo em papel começa com a petição entregue à secretaria do juízo. A partir daí, é feita a autuação, ou seja, a colocação de capa e numeração das páginas com respectivas rubricas do servidor. Feito isso, o servidor coloca o carimbo de “conclusão” na última página, preenche a data, assina e encaminha o processo ao juiz para despacho.


O trabalho de juntar petições e documentos aos autos também demanda muito tempo dos servidores. No processo eletrônico, o trabalho manual será eliminado: tudo será feito automaticamente pelo sistema de computação. Assim, o processo chegará mais rápido ao juiz, que precisará de maior número de assessores para atender à nova dinâmica.


Já as funcionalidades na área criminal vão permitir, por exemplo, que a polícia e o Ministério Público encaminhem eletronicamente inquéritos e denúncias ao Judiciário.


Para Walter Nunes, a automação vai reduzir significativamente o trabalho da secretaria, “A burocracia é eliminada com a automação. A verdadeira reforma do Judiciário é a implantação do sistema nacional de processo eletrônico”, comenta.


O PJE, segundo ele, vai acelerar o trâmite dos processos de forma geral. Atualmente, um recurso demora em média seis meses para chegar ao Superior Tribunal de Justiça (STJ). O tempo é gasto nas etapas burocráticas de preparação do processo para encaminhamento ao tribunal.


Parceria – O Processo Judicial Eletrônico foi desenvolvido a partir da avaliação de iniciativas isoladas dos tribunais regionais da 4ª e da 5ª Região, sob a coordenação dos juízes auxiliares da Presidência do CNJ, Marivaldo Dantas e Paulo Cristóvão Silva Filho. Numa parceria com o Conselho, o TRF 5 implantou o PJE em todas as suas unidades.


Segundo Walter Nunes, o TRF 5 desenvolveu um sistema para o Juizado Especial e a partir dessa plataforma foi desenvolvido o PJE, todo ele em software livre. Com a implantação da nova ferramenta, não haverá mais processo de papel. Atualmente, vários tribunais dispõem de alguns serviços eletrônicos, como o recebimento de petições. Mas o documento eletrônico é impresso pela Justiça para montar o processo físico. No PJE, o processo será eletrônico do início ao fim, nos moldes do que acontece ontem no CNJ.


O marco legal para o PJE foi instituído em 2006, com a aprovação de projeto de lei de iniciativa da Associação dos Juízes Federais (Ajufe), apresentado em 2000. A fase mais complexa, segundo Walter Nunes, é a atual, a de instalação de ferramentas eletrônicas. “Não estamos apenas informatizando, estamos automatizando o Judiciário”, comenta.


Walter Nunes lembra que o processo eletrônico exigirá computadores com duas telas – uma para a leitura do processo e outra para o despacho do juiz. Além disso, os tribunais precisam de link com velocidade mínima de 2 mbps, conforme já regulamentado pelo CNJ, que dispõe de programa de apoio à modernização tecnológica do Judiciário. Também participaram da reunião, os juízes José Eduardo Jr e Danilo Pereira; o escrivão da Polícia Federal, Ubiratan Sanderson; Flávio Visentini, da Justiça Federal do Rio Grande do Sul; os delegados federais Vladimir Rogério e Nilson Santos; José Carlos Abelaira e Sérgio Garcia, do TRF4.


FONTE: CNJ

segunda-feira, 25 de outubro de 2010

Abelhas fazem cálculos complexos para determinar rota mais curta de voo


Abelhas podem solucionar problemas matemáticos complexos, superando até a capacidade de computadores para cálculos.


Esse é o cerne de um estudo desenvolvido por cientistas do departamento de ciências biológicas, a Royal Holloway, da Universidade de Londres, no Reino Unido.


Os insetos aprendem a pegar a rota mais curta para chegar até as flores que costumam ser encontradas aleatoriamente pelo caminho. Ou seja, a que economiza tempo e poupa gasto de energia, um dos princípios da questão matemática conhecida como "problema do caixeiro-viajante" ("traveling salesman problem", em inglês).


João Justi Junior/Divulgação
Como computadores, abelhas processam rota de voo com menor distância e de menor gasto de energia


"Apesar de seu pequeno cérebro, elas são capazes de façanhas extraordinárias", comenta Nigel Raine, que participou da pesquisa.


A conclusão foi possível com a ajuda de um computador que controlou flores artificiais para identificar o comportamento das abelhas.


A ideia era mostrar se os insetos seguiam uma rota comum conforme encontravam as flores ou se procuraram instintivamente a mais curta. Depois de explorar o região florida, elas rapidamente tendem a voar pela rota mais curta.


Os dados do estudo serão publicados no jornal "The American Naturalist" ainda nesta semana.


FONTE: FOLHA ONLINE / DAS AGÊNCIAS DE NOTÍCIAS

sábado, 14 de agosto de 2010

Solução para maior problema da computação está provavelmente errada


Divulgada inicialmente como a solução para a maior questão na ciência da computação, a mais recente tentativa de resolver o problema "P vs. NP" está agora sendo questionada.

Dois importantes cientistas da computação encontraram "falhas fatais" na versão da prova apresentada por Vinay Deolalikar, funcionário dos Laboratórios Hewlett-Packard em Palo Alto, na Califórnia.

Desde que a prova de cem páginas foi divulgada na internet na semana passada, matemáticos e cientistas da computação estão em uma luta contra o tempo tentando entendê-la.

O problema está relacionado à velocidade com que um computador consegue completar tarefas como a fatoração de números. Grosso modo, "P" é o conjunto de problemas que pode ser computado rapidamente, enquanto "NP" contem os problemas cujas respostas podem ser checadas rapidamente, mas não resolvidos rapidamente do zero.

Suspeitava-se que P fosse diferente de NP (P =/= NP). Se isso for verdade, imporia limites severos na capacidade de processamento de computadores. Deolalikar afirma ter provado isso. Se sua prova estiver correta, ele ganhará o Prêmio do Milênio, de US$ 1 milhão (R$ 1,78 milhão), oferecido pelo Instituto Clay de Matemática, sediado em Cambridge, Massachusetts.

BURACO SÉRIO

Grande parte da animada discussão on-line sobre a prova aconteceu no blog de Richard Lipton, um cientista da computação do Instituto de Tecnologia da Geórgia, EUA. Lipton tem 30 anos de experiência na questão "P vs. NP".

Hoje de manhã, porém, Lipton postou um e-mail de outro cientista, Neil Immeman, da Universidade de Massachusetts, EUA, que afirma ter encontrado um "sério buraco" no artigo de Deolalikar.

O principal argumento de Immerman seria um erro nas hipóteses quando tentou descrever o conjunto P de uma determinada maneira. Deolalikar tenta mostrar que alguns problemas estão em NP, mas não em P - o que demonstraria que P=/= NP - invocando outro conjunto matemático conhecido como FO.

Immerman diz que esse conjunto não pode ser usado dessa forma por causa de outros métodos usados na prova.

Como todos problemas matemáticos famosos, tentativas de resolver "P vs. NP" são comuns, mas poucas são levadas a sério porque não tendem a ter fundamentos teóricos fortes.

A empolgação com a prova de Deolalikar parece ter sido estimulada por seu status profissional como pesquisador da HP e por um comentário de Stephen Cook, da Universidade de Toronto, formulador do problema "P vs. NP", que afirmou que o trabalho de Deolalikar parecia ser uma "asserção relativamente séria".

TRÊS CENÁRIOS

Ao comentar sobre o blog de Lipton alguns dias atrás, Terence Tao, da Universidade da Califórnia em Los Angeles, propôs três cenários a respeito da correção da prova.

No melhor caso, pequenas mudanças consertariam o argumento de Deolalikar e provariam de uma vez por todas que P =/= NP. Outra possibilidade é que grandes mudanças no argumento poderiam ainda salvar a prova. Por fim, a estratégia de prova geral de Deolalikar poderia fornecer subsídios para tentativas futuras de provar o argumento.

Tao continuou afirmando que os dois primeiros cenários são improváveis, mas o terceiro ainda não estava resolvido.

Mesmo que as críticas estejam corretas, o incidente como um todo pode ainda estimular descobertas matemáticas. Uma página wiki foi montada onde é possível postar opiniões sobre a prova de Deolalikar. Comentários variam de correções de pequenas erros de digitação a críticas detalhadas dos métodos matemáticos empregados.

Essa efervescência de atividade on-line sugere que um novo modo de fazer matemática pode estar surgindo, com blogs e wikis rivalizando com quadros negros e revistas científicas - um resultado potencialmente positivo, mesmo que a questão do "P vs. NP" continue sem solução.

"A internet está fazendo uma enorme diferença na forma como os matemáticos operam", diz Timothy Gowers, da Universidade de Cambridge. "Um processo que poderia ter levado semanas e semanas ocorreu muito rapidamente."


FONTE: FOLHA ONLINE / DA NEW SCIENTIST
 
Notícia divulgada em 13/08/2010
"Número de Deus" é 20, dizem matemáticos


Após anos de tentativas, pesquisadores conseguiram mostrar que é possível resolver em até 20 movimentos o "Cubo de Rubik" - um quebra-cabeça 3D criado em 1974 pelo húngaro Ernõ Rubik - a partir de qualquer arranjo inicial.


´
Cubo de Rubik, quebra-cabeça 3D criado pelo húngaro Erdõs Rubik em 1974, pode ser resolvido com até 20 movimentos


O feito foi realizado pela combinação do poder dos computadores usados pelo Google com alguns insights matemáticos, o que permitiu checar todas as 43 quintilhões de possíveis posições que o cubo pode assumir.

SXC

"O grande avanço foi descobrir um meio de resolver tantas posições, todas de uma vez, a uma grande velocidade", afirmou Tomas Rokicki, programador de Palo Alto, Califórnia, que passou os últimos 15 anos procurando pelo número mínimo de movimentos necessários para resolver qualquer configuração do Cubo de Rubik.

Esse número mínimo de movimentos é chamado de "Número de Deus", pois nem o Todo Poderoso conseguiria resolver mais rapidamente o quebra-cabeças.

EXPLORANDO A SIMETRIA

Para simplificar o problema, Rokicki e colaboradores usaram técnicas de um ramo da matemática chamado teoria de grupos.

Primeiro eles dividiram todas as possíveis configurações iniciais em 2,2 bilhões de conjuntos, cada um contendo 19,5 bilhões de configurações (2,2 bilhões x 19,5 bilhões = 42,9 quintilhões). O critério da divisão foi a maneira como essas configurações respondiam a um grupo de 10 movimentos possíveis.

Esse agrupamento permitiu que a equipe reduzisse o número de conjuntos para 56 milhões ao explorar as simetrias do cubo. Por exemplo, virar o cubo de cima para baixo não torna o problema mais difícil, então essas posições equivalentes podem ser ignoradas.

Isso ainda deixa um vasto número de configurações iniciais para ser checadas. A equipe então desenvolveu um algoritmo para acelerar esse processo.

BECOS SEM SAÍDA

Métodos anteriores resolviam cerca de 4.000 cubos por segundo, tentando um conjunto de posições iniciais e determinando se a posição resultante o aproximava da solução. Se não o fizesse, o algoritmo se desfazia desses movimentos e começava de novo.

O insight de Rokicki foi notar que esses becos sem saída são, na realidade, soluções para um cubo com uma posição inicial diferente. Isso o levou a um algoritmo que conseguia tentar um bilhão de cubos por segundo.

Uma maneira de entender seu algoritmo (conjunto de regras para solução de um problema) é a seguinte: suponha que a tarefa seja visitar um amigo em uma cidade desconhecida e que você tenha recebido instruções para virar à esquerda ou à direita, mas que as instruções não tenham incluído a posição inicial. Se você seguir as instruções a partir de uma posição inicial qualquer, é improvável que chegue a seu destino. Mas pareando os movimentos direita-esquerda à posição inicial correta o levará ao destino.

Da mesma forma, o algoritmo da equipe rapidamente pareia movimentos com a posição inicial correta, permitindo a resolução de cada conjunto de 19,5 bilhões de configurações em 20 segundos.

IMPÉRIO DA COMPUTAÇÃO

Mesmo a essa velocidade, levaria 35 anos para completar toda a tarefa em um computador pessoal. A solução da equipe foi pedir ajuda ao Google.

O engenheiro da empresa John Dethridge, em Mountain View, Califórnia, conseguiu acesso aos supercomputadores da empresa para resolver o problema em semanas.

Sabia-se que algumas configurações iniciais requerem apenas 20 movimentos para serem resolvidas, e alguns matemáticos suspeitavam que nenhuma configuração exigiria mais do que isso. A busca exaustiva da equipe de Rokicki mostra que a suspeita estava correta.

"Pesquisa desse tipo mostra como matemática pura pode ser usada para transformar problemas computacionais difíceis em problemas mais tratáveis", diz Mark Kambites, um matemático na Universidade de Manchester que não participou do trabalho. "O Cubo de Rubik é um caso interessante para os métodos de teoria de grupos computacional."

O trabalho ainda precisa passar pelo crivo da revisão por pares, mas Rokicki ressalta que a pesquisa é uma extensão de um trabalho anterior publicado no periódico "The Mathematical Intelligencer". Naquele trabalho, o "Número de Deus" havia sido reduzido para 22.


FONTE: FOLHA ONLINE / DA NEW SCIENTIST


Notícia publicada em 11/08/2010

sexta-feira, 30 de julho de 2010

Yahoo pagará R$ 30 mil a mulher que teve fotos íntimas expostas em site


A Câmara Regional Especial de Chapecó fixou em R$ 30 mil a indenização que a Yahoo do Brasil deverá pagar para uma mulher que teve fotos íntimas expostas em site da Internet, disponibilizado através da empresa, por sete dias. O material só foi bloqueado após o ajuizamento de ações cautelar e indenizatória pela vítima, em comarca da região Oeste do Estado. As fotos foram tiradas por um ex-namorado e localizadas em seu computador, apreendido judicialmente.

Em 1º Grau, a ação foi julgada improcedente. Em sua apelação, a mulher reforçou os argumentos da inicial e pediu a condenação do Yahoo e do rapaz. A empresa argumentou que a responsabilidade sobre o site era do ex-namorado, face a comprovação das fotos em seu computador. A perícia, porém, não comprovou a criação do site a partir do equipamento apreendido. O perito concluiu que as imagens um dia estiveram naquele computador, o que nunca foi negado pelo rapaz, mas não pode afirmar por conta disso que a ele caberia responsabilidade pela criação do site – atitude sempre negada pelo ex-namorado.

Ao votar pela reforma parcial da sentença, o relator, desembargador substituto Saul Steil, entendeu que meros indícios não poderiam ser considerados prova contra o namorado. Em relação à Yahoo, porém, ele reconheceu que se enquadra no conceito de fornecedor, com prestação de serviços com remuneração indireta com venda de publicidade nas páginas, sem cobrança para hospedagem dos sites.

Assim, Steil afirmou que não é possível negar que a mulher foi vítima, numa relação de consumo, devendo ser aplicadas as regras previstas no Código de Defesa do Consumidor. O desembargador lembrou que a mídia divulga com frequência crimes similares ao caso cometidos através de sites. Ele destacou que muitos estão relacionados a crimes contra a honra e crimes sexuais, em especial aos crimes de pedofilia e outros ligados a crianças e violência.

Steil disse, ainda, que afastar a responsabilidade da empresa nestes crimes, por ter retirado o site do "ar" após a cautelar, não era suficiente. Esclareceu que empresas que hospedam sites na Internet devem filtrar esse tipo de divulgação, antes de levar à circulação na internet o conteúdo criminoso.

“Incumbe ao Judiciário coibir tal prática. Não se admite que uma empresa deste porte, com todos os sistemas modernos que se encontram à sua disposição, permita tal veiculação sem filtrar seus conteúdos”, concluiu Steil. A votação foi unânime. A empresa ainda pode recorrer aos tribunais superiores.


FONTE: TJSC

terça-feira, 6 de julho de 2010

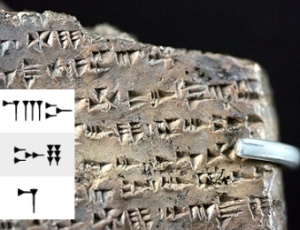
Computador decifra língua extinta


Das 30 letras do alfabeto extinto, o sistema foi capaz de mapear corretamente 29 com seus correspondentes em hebraico


No livro Lost Languages, de 2002, o então editor do suplemento de educação superior do jornal inglês The Times, Andrew Robinson, afirmou que o trabalho arqueológico de decifrar línguas extintas exige uma mistura de lógica e intuição que os computadores são incapazes de possuir.


Pesquisadores do Instituto de Tecnologia de Massachusetts e da Universidade do Sul da Califórnia, nos Estados Unidos, tentam mostrar que Robinson estava errado.


Em estudo que será apresentado esta semana na reunião anual da Associação para Linguística Computacional, em Uppsala, na Suécia, o grupo apresentará um novo programa de computador que foi capaz de decifrar grande parte do extinto idioma ugarítico, descoberto a partir de escritos encontrados na cidade perdida de Ugarit, na Síria, cujas ruínas foram encontradas em 1928.


O ugarítico era uma língua semítica escrita em alfabeto cuneiforme com 27 consoantes e três vogais. Os escritos encontrados foram importantes para estudiosos do Velho Testamento, por auxiliar a clarificar textos hebraicos e revelar como o judaísmo utilizava frases comuns, expressões literárias e frases empregadas pelas culturas gentis que o cercavam.


O sistema, além de ajudar a decifrar línguas antigas que continuam a resistir aos esforços de especialistas, poderá expandir o número de idiomas que sistemas automatizados de tradução, como o Google Tradutor, são capazes de manejar.


Para simular a intuição que falta aos computadores, Regina Barzilay, do Laboratório de Inteligência Artificial e Ciência da Computação do MIT, e colegas fizeram várias proposições. A primeira é que a língua a ser decifrada pelo computador estaria próxima de outra. Para isso, foi escolhido o hebraico.


Outra asserção é que haveria um modo sistemático de mapear o alfabeto de uma língua com relação ao alfabeto de outra, e que os símbolos relacionados deveriam ocorrer com frequências semelhantes nas duas línguas.


O sistema também fez asserções no nível semântico, no sentido de que as línguas relacionadas teriam pelo menos alguns cognatos, isto é, palavras com raízes em comum.


Por meio de um modelo probabilístico usado em pesquisas em inteligência artificial, os pesquisadores determinaram nos mapeamentos os radicais semelhantes e conjuntos de sufixos e prefixos consistentes, entre outras relações entre as palavras das duas línguas.


O ugarítico já havia sido decifrado. Se não tivesse sido, os autores do estudo não teriam como avaliar a performance do sistema que desenvolveram.


“O sistema repetiu as análises dos dados resultantes centenas de vezes. E, a cada vez, os acertos eram mais frequentes, pois estávamos chegando mais perto de uma solução consistente. Finalmente, chegamos a um ponto no qual a alteração do mapeamento das similaridades não aumentava mais a consistência dos resultados”, disse outro autor do estudo, Ben Snyder, também do MIT.


Das 30 letras do alfabeto extinto, o sistema foi capaz de mapear corretamente 29 com seus correspondentes em hebraico. Cerca de um terço das palavras em ugarítico tem cognato em hebraico e, desse total, o sistema identificou corretamente 60%.


“Das palavras identificadas incorretamente, na maior parte das vezes o erro foi por apenas uma palavra. Ou seja, o sistema deu palpites bem razoáveis”, disse Snyder.


Apesar dos índices de acerto, os pesquisadores destacam que o sistema não é suficientemente bem resolvido para substituir os tradutores humanos. Mas, segundo eles, é uma ferramenta poderosa cujo desenvolvimento poderá ajudar no processo de decifrar línguas desconhecidas e de traduzir outras existentes mais eficientemente.


O artigo A Statistical Model for Lost Language Decipherment, de Regina Barzilay e outros, pode ser lido em people.csail.mit.edu/bsnyder/papers/bsnyder_acl2010.pdf.


FONTE: UOL / Da Agência Fapesp

Notícia divulgada em 05/07/2010 - 12h16